

Η λειτουργία του πρώτου ελληνικού κέντρου τεχνητής νοημοσύνης, οι προσδοκίες για τον ψηφιακό μετασχηματισμό της χώρας, αλλά και η στρατηγική αξιοποίηση υπερ-υποδομών εθνικής εμβέλειας αναμένεται να αναλυθούν, για πρώτη φορά σε επίπεδο συνεδρίου, μέσα από τις εργασίες του AIForum26.
Το συνέδριο, το οποίο αποτελεί το πέμπτο κατά σειρά ετήσιο φόρουμ για την τεχνητή νοημοσύνη, διοργανώνεται από το AI Catalyst σε συνεργασία με την ethosGROUP και πραγματοποιείται σήμερα Πέμπτη 5 Νοεμβρίου 2026, από τις 09:00 έως τις 17:00, στο ξενοδοχείο Divani Caravel, προσφέροντας παράλληλη δυνατότητα διαδικτυακής παρακολούθησης μέσω της υβριδικής πλατφόρμας LiveOn Events+.
«Από τα Δεδομένα στις Υποδομές — Χτίζοντας το AI Οικοσύστημα της Ελλάδας» ήταν το κεντρικό θέμα του 1ου πάνελ στο οποίο συμμετείχαν οι κ.κ. Δημοσθένης Αναγνωστόπουλος, Γενικός Γραμματέας στο υπουργείο Ψηφιακής Διακυβέρνησης, Αφροδίτη Σεβαστή, CEO, Pharos AI Factory S.A., Κυριάκος Τόλιας, Διευθυντής του Εθνικού Κέντρου Τεκμηρίωσης και Ηλεκτρονικού Περιεχομένου, Γεώργιος Κανέλλος, Διευθυντής του Ιδιαίτερου Γραφείου του Ειδικού Γραμματέα Τεχνητής Νοημοσύνης και Διακυβέρνησης Δεδομένων στο Υπουργείο Ψηφιακής Διακυβέρνησης, Αλέξανδρος Μελίδης, Γενικός Διευθυντής του Οργανισμού Ανοιχτών Τεχνολογιών (ΕΕΛΛΑΚ), Φώτης Παναγιωτόπουλος, Managing Director και Strategy & Consulting Lead της Accenture στην Ελλάδα
Οι συμμετέχοντες τοποθετήθηκαν ως εξής:
O κ. Αναγνωστόπουλος τόνισε: Στο κομμάτι των υποδομών, οι δημόσιοι και ιδιωτικοί φορείς χρειάζονται υπολογιστικούς πόρους. Σήμερα, η πρόσβαση γίνεται κυρίως μέσω hyperscalers (Azure, Google Cloud, AWS) με κατανάλωση credits. Παράλληλα, έρχεται ο υπερυπολογιστής «Δέδαλος» μέσω του «Φάρου», που θα προσφέρει δωρεάν πρόσβαση για 2 χρόνια σε startups, ΜΜΕ, ακαδημαϊκά ιδρύματα και το δημόσιο. Ωστόσο, στο δημόσιο πρέπει να μπει τάξη: ο λογαριασμός των υπολογιστικών πόρων πρέπει να μεταφέρεται στον φορέα που έχει την ανάγκη και την κατανάλωση, αποφεύγοντας τη λογική του “τζάμπα”. Επίσης, στα mission-critical συστήματα του δημοσίου (π.χ. Κτηματολόγιο, ελέγχους), η τελική απόφαση πρέπει να λαμβάνεται πάντα από άνθρωπο (human-in-the-loop) με πλήρη ιχνηλασιμότητα (traceability) και λογοδοσία (accountability). Τέλος, στο πεδίο των δεξιοτήτων (skills), παρατηρείται μεταβολή: οι entry-level θέσεις προγραμματιστών (20-30 ετών) θα καλύπτονται σε μεγάλο βαθμό από AI, οπότε πρέπει να αναβαθμίσουμε τα προσόντα των αποφοίτων μας για να παραμείνουν απαραίτητοι.
Η κα Σεβαστή ανέφερε: Ο «Φάρος» αποτελείται από την εταιρεία αλλά και ένα ευρύτερο κονσόρτσιουμ εταίρων (ΕΔΥΤΕ, ΕΝΠ/ΕΜΠ, Δημόκριτος, Ερευνητικό Κέντρο Αθηνά και ΕΚΤ). Ο «Δέδαλος» εγκαταστάθηκε και εγκαινιάστηκε, ενώ από τον Αύγουστο ολοκληρώσαμε τον πρώτο κύκλο στελέχωσης. Στόχος μας είναι να δημιουργήσουμε τον λειτουργικό και τεχνικό μηχανισμό ώστε ένας κλειστός, εξειδικευμένος υπερυπολογιστής να γίνει εύκολα προσβάσιμος και χρήσιμος. Αναπτύσσουμε μια κεντρική πλατφόρμα (παρόμοια με των hyperscalers) όπου μια εταιρεία θα κάνει KYC, θα δηλώνει τις ανάγκες της, θα δεσμεύει πόρους και θα εκτελεί τα μοντέλα της. Ετοιμάζουμε ένα “Startup Package” με minimum πόρους για startups, καθώς και εξειδικευμένες συμβουλευτικές υπηρεσίες για ανάπτυξη εξειδικευμένων μικρών γλωσσικών μοντέλων (Small Language Models – SLMs) σε τομείς όπως ο πολιτισμός και ο τουρισμός. Επίσης, σε συνεργασία με την NVIDIA διοργανώνουμε agentic bootcamps και παρέχουμε online εκπαιδεύσεις μέσω ΕΔΥΤΕ.
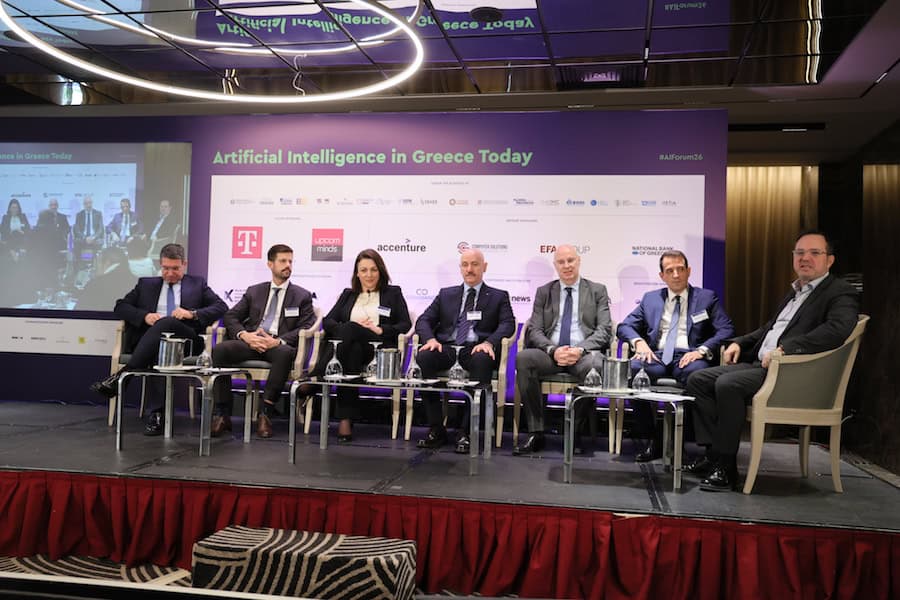
Ο κ. Τόλιας είπε: Το ΕΚΤ συμμετέχει ως συνδεδεμένος εταίρος (associated partner) στο έργο του «Φάρου». Διαθέτουμε τον πλούτο της εθνικής ερευνητικής δραστηριότητας. Αναπτύξαμε πιλοτικά την εφαρμογή «Διδακτορικά AI», έναν βοηθό για τον Έλληνα ερευνητή βασισμένο σε αρχιτεκτονική RAG (Retrieval-Augmented Generation), διασφαλίζοντας ότι δεν παραβιάζονται τα πνευματικά δικαιώματα των διδακτόρων. Παράλληλα, μέσω του Data Marketplace παρέχουμε εργαλεία ανωνυμοποίησης δεδομένων υψηλού επιπέδου. Στον πολιτιστικό τομέα, μέσω της πύλης Search Culture διαθέτουμε πάνω από 1,2 εκατομμύρια τεκμηριωμένα τεκμήρια πολιτισμού έτοιμα για χρήση από ερευνητές και μοντέλα AI. Συμφωνώ απόλυτα ότι η Ελλάδα δεν πρέπει να ανταγωνιστεί στα γενικά LLMs των δισεκατομμυρίων, αλλά να αναπτύξει εξειδικευμένα SLMs σε τομείς όπως ο πολιτιστικός τουρισμός, διατηρώντας την εθνική ψηφιακή αυτονομία.
O κ. Κανέλλος στην ερώτηση για το τι προβλέπει το κανονιστικό πλαίσιο του EU AI Act, πού βρίσκεται η Ελλάδα και τι ισχύει με τα ανοιχτά δεδομένα, απάντησε ως εξής: Χρειάζεται ψυχραιμία. Η Ελλάδα ήταν η 7η χώρα στην ΕΕ που εισήγαγε εθνικό εφαρμοστικό πλαίσιο για τον AI Act (Νόμος 5321/2026). Το πλαίσιο ορίζει την ΕΕΤΤ ως κεντρική αρχή εποπτείας αγοράς και προβλέπει αυστηρά πρόστιμα (έως 7% του παγκόσμιου τζίρου ή 35 εκατ. €). Ωστόσο, η φιλοσοφία της Ειδικής Γραμματείας δεν είναι η επιβολή κυρώσεων, αλλά η υποστήριξη των επιχειρήσεων. Γι’ αυτό δημιουργούμε το Ρυθμιστικό Δοκιμαστήριο (Regulatory Sandbox) σε συνεργασία με τον «Φάρο» έως τον Αύγουστο 2027. Σχετικά με τα χρονοδιαγράμματα: οι απαγορευμένες πρακτικές ισχύουν από Φεβρουάριο 2025, οι κανόνες διαφάνειας (επισήμανση AI generated περιεχομένου) εφαρμόζονται πλήρως από τον Δεκέμβριο 2025, ενώ τα συστήματα υψηλού ρίσκου (High-Risk) θα τεθούν σε εφαρμογή τον Δεκέμβριο 2026 και Δεκέμβριο 2028. Παράλληλα, αναβαθμίσαμε το εθνικό portal δεδομένων data.gov.gr (πλέον με 22.000+ σύνολα δεδομένων από 600+ φορείς εναρμονισμένα με το πρότυπο DCAT-AP) και θεσπίζουμε το δίκτυο των Data Officers στο δημόσιο.
O κ. Μελίδης είπε: Η χώρα έκανε μεγάλο βήμα αναγνωρίζοντας την υπολογιστική ισχύ ως υποδομή, αλλά πρέπει να πράξει το ίδιο και για τα δεδομένα. Στις διεθνείς βιβλιοθήκες εκπαιδευσης AI, τα ελληνικά δεδομένα αντιπροσωπεύουν μόλις το 1%, έναντι 50% των αγγλικών. Αν δεν τροφοδοτήσουμε τα μηχανήματά μας με ποιοτικά ελληνικά δεδομένα, τα μοντέλα δεν θα μιλούν καλά ελληνικά. Η ΕΕΛΛΑΚ διαθέτει μέσω του Γλωσσάπη πάνω από 45 ανοιχτά σύνολα δεδομένων και εκπαίδευσε το open source μοντέλο Greek BERT. Πρέπει να ψηφιοποιηθούν και να απελευθερωθούν τα “ιδιωτικά δημόσια δεδομένα” που βρίσκονται εγκλωβισμένα σε φορείς. Το νέο data.gov.gr κινείται στη σωστή κατεύθυνση, αλλά το στοίχημα είναι η επαναχρησιμοποίηση δεδομένων από την οικονομία. Προγραμματίζουμε Datathons/Hackathons για να έρθουν μικρομεσαίες επιχειρήσεις και νέοι προγραμματιστές να αναπτύξουν εφαρμογές.
O κ. Παναγιωτόπουλος ανέφερε: Οι επιχειρήσεις δεν έχουν πρόβλημα υιοθέτησης AI, αλλά πρόβλημα παραγωγικής κλίμακας. Μελέτες του MIT δείχνουν ότι μόλις το 5% των έργων Generative AI αποδίδουν ουσιαστικά αποτελέσματα στο bottom line. Για να πετύχει μια επιχείρηση, απαιτούνται τέσσερις παράγοντες: 1) Reinvention (Επανεφεύρεση): Ολικός επανασχεδιασμός των διαδικασιών από την αρχή, όχι απλή προσθήκη Copilot σε παλιές δομές. 2) Εκπαίδευση & Reskilling: Η τεχνολογία δεν παράγει παραγωγικότητα μόνη της· χρειάζεται εμπιστοσύνη και κατάρτιση των ανθρώπων. 3) Ενοποίηση δεδομένων σε κεντρική πλατφόρμα. 4) Διακυβέρνηση: Ο AI Act λειτουργεί ως επιταχυντής για ρυθμιζόμενους κλάδους (τράπεζες, ασφάλειες, υγεία) παρέχοντας ασφάλεια δικαίου. Επιπλέον, το AI πρέπει να αντιμετωπίζεται ως όχημα ανάπτυξης (growth) και όχι απλά περικοπής κόστους. Όπως δείχνει το Jevons Paradox, όταν μια τεχνολογία γίνεται πιο αποτελεσματική, η συνολική ζήτηση και η απασχόληση αυξάνονται. Στην Accenture, 815.000 εργαζόμενοι παγκοσμίως έχουν πρόσβαση σε AI εργαλεία. Για να επιταχύνουμε στην Ελλάδα, το δημόσιο πρέπει να λειτουργήσει ως βασικός πελάτης (anchor customer), να δοθούν εύκολα πακέτα πρόσβασης (startup packages, credits) στις ΜΜΕ και να συνδεθούμε με το ελληνικό ταλέντο του εξωτερικού.
©Ελένη Παπαδάκη /PHOTOPRESS Θ&Α Αναγνωστόπουλοι








